← 전체 프로젝트

jangminseok.com

혼자 설계부터 백엔드, 화면, 평가, 배포까지 만들었습니다.

지금 보고 계신 포트폴리오 사이트입니다. 프로젝트 소개 페이지와 함께, 제 프로젝트에 대해 무엇이든 물어볼 수 있는 AI 챗봇을 만들었습니다.

챗봇은 프로젝트 문서를 찾아 근거가 된 프로젝트 설명 링크와 함께 답하고, 어떤 도구를 불렀는지도 그대로 보여 줍니다. 같은 도구를 Claude 같은 AI 앱에서도 쓸 수 있게 MCP 서버로도 열었습니다.

2026-09-29 ~ 진행 중개인 프로젝트
jangminseok.com 대표 화면

0.962

답변 근거 적중률

시험 문제 26개 중 정답 문서를 상위 5개 안에 찾은 비율, 소개 페이지 전환 전 측정

1.0

숫자 검증 통과율

답변의 숫자가 모두 실제 문서에 있는 비율, 소개 페이지 전환 전 측정

0원

월 운영비

도메인 비용 제외

주요 기능

포트폴리오에 질문하는 AI 챗봇

핵심 기능

포트폴리오에 질문하는 AI 챗봇

화면 아래 입력창에 질문하면 AI가 제 프로젝트 문서를 찾아 답합니다. 답 끝에는 근거가 된 프로젝트 페이지 링크가 붙습니다. 포트폴리오에 없는 질문에는 답하지 않습니다.
어떤 도구를 불렀는지 공개

핵심 기능

어떤 도구를 불렀는지 공개

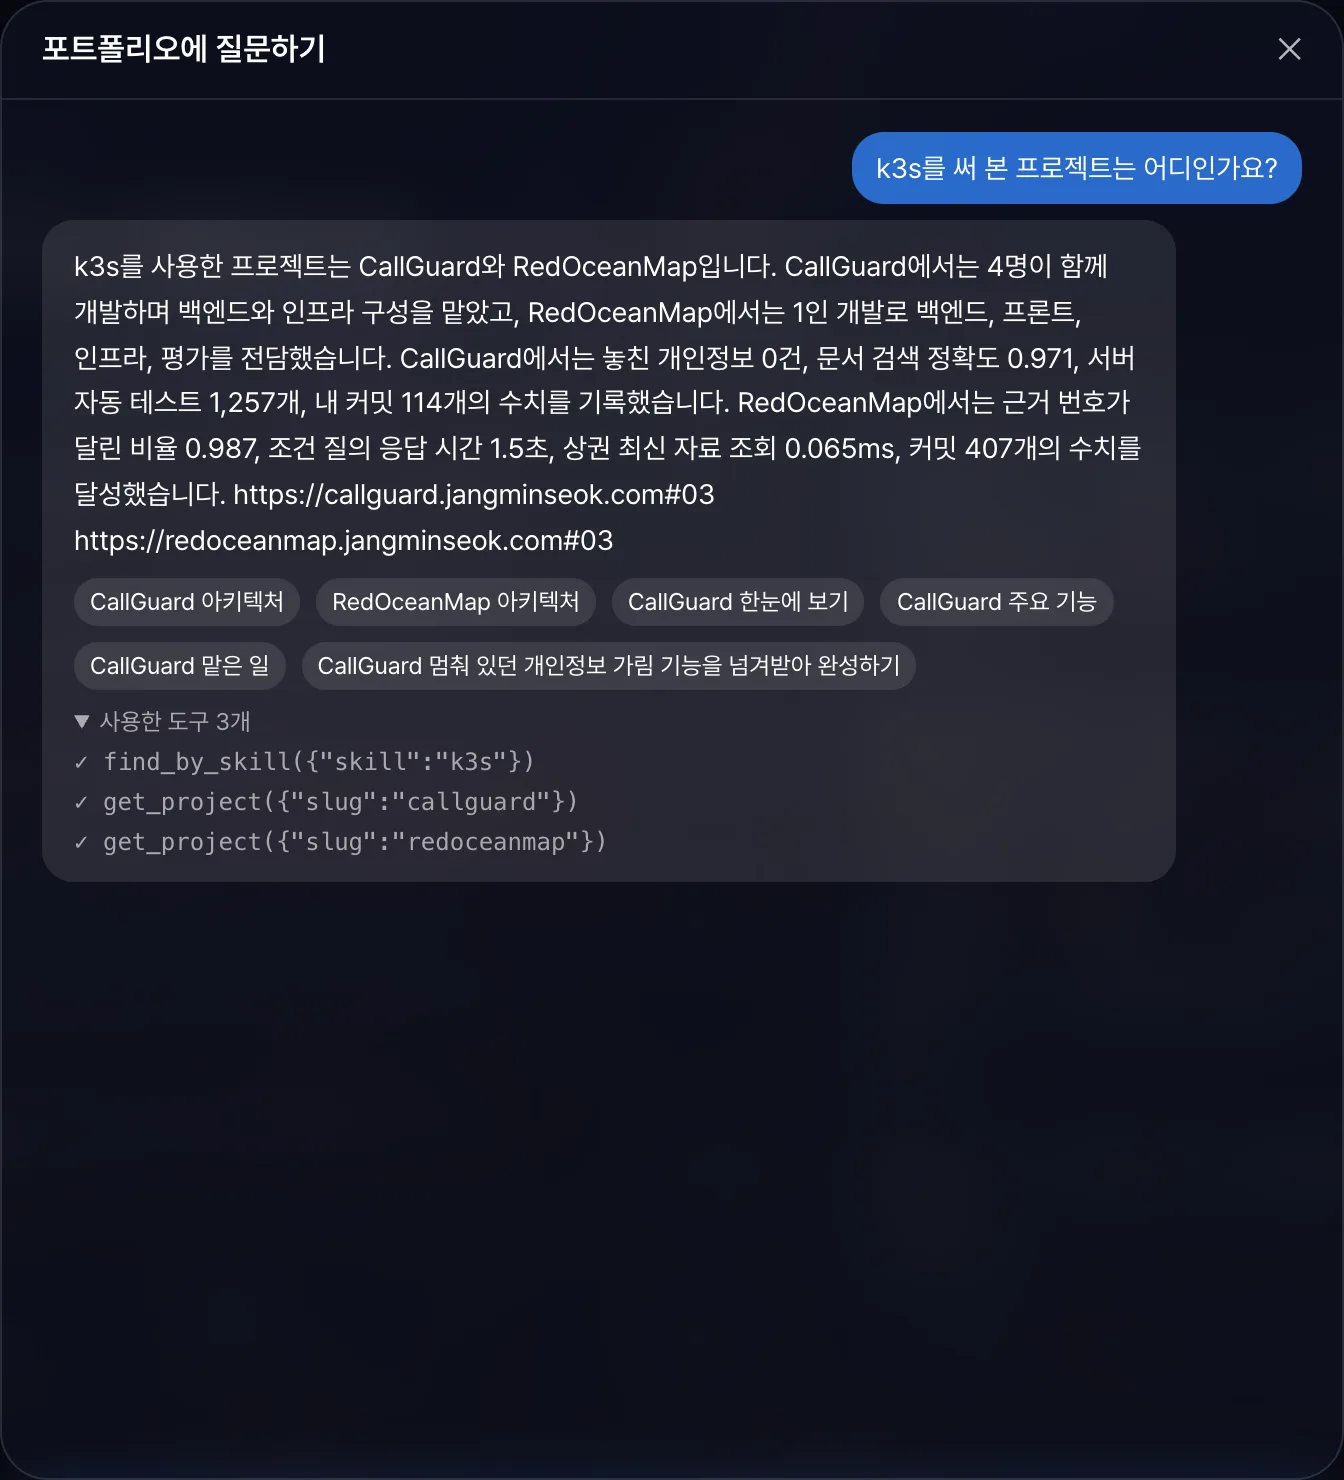
답변마다 AI가 어떤 도구를 어떤 값으로 불렀는지 펼쳐 볼 수 있습니다. 문서 검색, 프로젝트 조회, 기술별 프로젝트 찾기 도구 3개를 상황에 맞게 골라 씁니다.
  • 다른 AI 앱에서 쓰는 MCP 서버

    다른 AI 앱에서 쓰는 MCP 서버

    Claude 앱의 커넥터에 주소 하나(https://api.jangminseok.com/mcp/)를 등록하면, 그 앱의 AI가 같은 도구 3개로 제 포트폴리오를 조회할 수 있습니다.
  • 프로젝트 소개 페이지

    프로젝트 소개 페이지

    프로젝트마다 무엇을 만들었는지, 주요 기능, 전체 구조, 맡은 일, 어려웠던 점을 한 페이지에서 읽을 수 있습니다. 각 프로젝트는 callguard.jangminseok.com처럼 자기 주소를 가집니다.
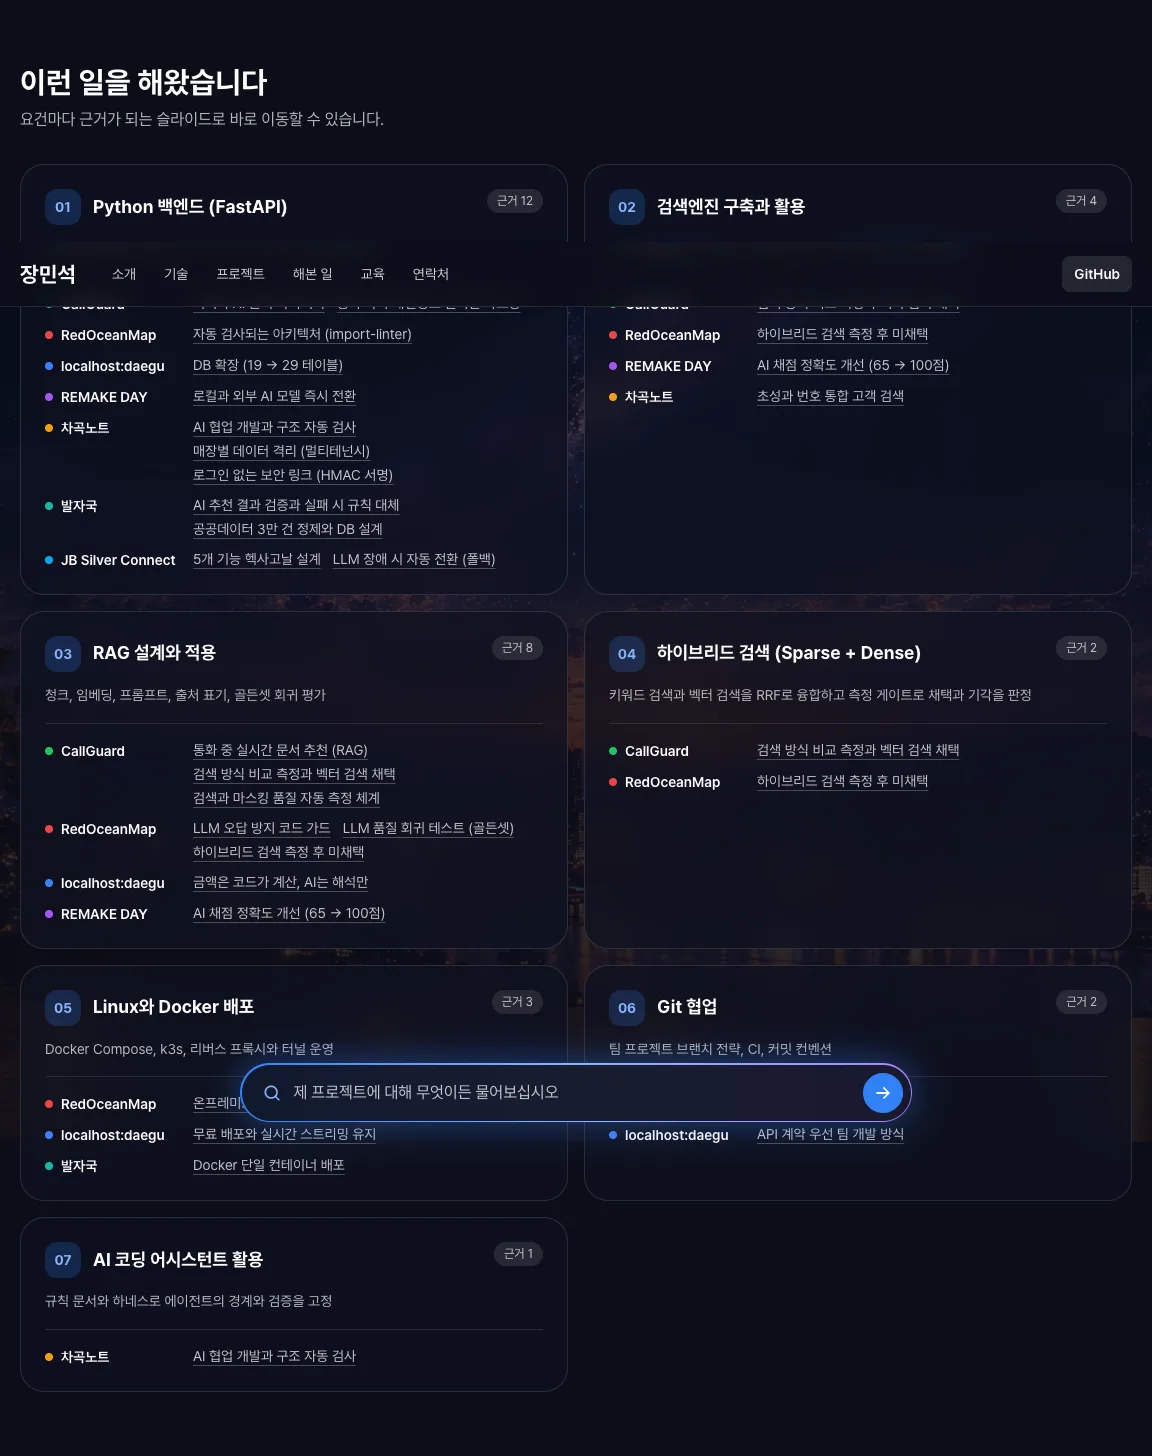
  • 채용 요건별 근거 카드

    채용 요건별 근거 카드

    채용 공고에서 자주 보는 요건마다, 그 경험을 보여 주는 프로젝트 페이지로 바로 이어지는 카드를 모았습니다.

아키텍처

화면은 Next.js로, 챗봇과 MCP 서버는 FastAPI 하나로 만들었습니다. 두 입구가 같은 도구 코드를 불러서, 한쪽만 고쳐지는 일이 없습니다.
전체 구조 도식

도구는 한 번만 만들고 입구는 둘

문서 검색, 프로젝트 조회, 기술별 찾기 도구를 한곳에 만들고, 사이트 챗봇과 MCP 서버는 그 도구를 부르는 입구로만 두었습니다. 입구가 도구 내부를 직접 건드리지 못하게 자동 검사 도구(import-linter)로 막았습니다.

숫자와 링크는 코드가 마지막에 확인

AI가 쓴 답에 문서에 없는 숫자가 있으면 그 문장을 지우고, 없는 페이지 링크도 지웁니다. 공개하면 안 되는 이름이 들어가면 답 전체를 막습니다. AI에게 부탁하는 대신 코드로 정해 두었습니다.

키워드와 의미를 함께 찾는 검색

문서를 조각으로 나눠 저장하고, 단어가 겹치는 정도와 뜻이 가까운 정도로 각각 찾은 뒤 두 순위를 합칩니다. 키워드 검색 방식은 두 가지를 같은 시험 문제로 재 보고 골랐습니다.

무료 한도 안에서 운영

화면과 서버는 Vercel, 데이터베이스는 Supabase, AI는 Gemini의 무료 한도로 돌립니다. 하루 한 번 서버가 DB를 깨워 무료 DB가 잠들지 않게 하고, 한꺼번에 많은 질문이 몰리지 않게 질문 수를 제한합니다.

화면
Next.js 16React 19TypeScriptTailwind CSS
서버
Python 3.13FastAPISQLAlchemy 2import-linter
검색과 AI
PostgreSQL + pgvectorpg_trgmGeminiMCP
배포
VercelSupabaseGitHub Actions

맡은 일

1인 프로젝트입니다. 설계 문서를 먼저 쓰고, 그 문서에서 나눈 작업 단위대로 테스트부터 작성하며 만들었습니다.

제가 한 일

  • ✓사이트 화면과 프로젝트 소개 페이지 구조 설계
  • ✓도구 3개와 AI가 도구를 고르는 흐름(최대 3번 호출)
  • ✓숫자, 링크, 금지어를 확인하는 답변 검사 장치
  • ✓문서를 조각으로 나눠 색인하고 두 방식으로 찾아 합치는 검색
  • ✓사이트 챗봇과 MCP 서버, 질문 수 제한
  • ✓시험 문제 30개로 챗봇을 채점하는 평가 도구
  • ✓Vercel, Supabase 배포와 CI

협업 방식

  • 설계 문서, 구현 계획, 작업별 기록을 먼저 남기고 그 순서대로 작업했습니다.
  • 계획과 다르게 정한 것은 이유와 틀렸을 때의 비용을 함께 기록했습니다.

AI 도구를 쓴 방식

  • Claude Code와 함께 개발했고, AI가 쓴 코드는 세 가지로 검증했습니다. 구조 규칙은 import-linter가, 기능은 백엔드 테스트 64개와 화면 테스트 68개가, 답변 품질은 시험 문제 평가가 확인합니다.
  • 테스트와 구조 규칙 검사는 push할 때마다 CI에서 돌아서, 깨진 코드가 바로 드러납니다.

어려웠던 점과 해결

  1. 1.무료 AI 한도가 하루 20번뿐이던 문제

    문제
    처음 고른 Gemini 모델은 무료로 하루 20번만 부를 수 있었습니다. 질문 하나에 AI를 2~4번 부르기 때문에 하루에 받을 수 있는 질문이 5~10개뿐이었습니다.
    해결
    무료 한도 표를 비교해 하루 500번까지 쓸 수 있는 경량 모델(Gemini 3.5 Flash Lite)로 바꿨습니다. 바꾸기 전에 이 모델도 도구를 제대로 고르는지 먼저 시험했습니다.
    결과
    하루에 받을 수 있는 질문이 약 125~250개로 늘었습니다. 질문 하나에 2~4번 부른다고 보고 계산한 값입니다. 대신 경량 모델이라 조회한 사실을 답에서 빠뜨리는 경우가 남았고, 평가에서 그대로 드러납니다.
  2. 2.두 번째 도구 호출부터 AI가 오류를 내던 문제

    문제
    로컬에서 챗봇을 처음 돌렸을 때, AI가 도구를 한 번 부른 뒤 다음 요청에서 400 오류가 났습니다.
    원인
    Gemini 3 계열은 도구를 부를 때 서명 값을 함께 주고, 다음 요청에서 그 서명을 그대로 돌려받아야 합니다. 설계 단계에서 이 조건을 몰랐습니다.
    해결
    대화 기록에 서명을 담아 다음 요청 때 돌려주도록 고쳤습니다. 이 동작을 확인하는 테스트를 먼저 쓰고 고쳤습니다.
    결과
    도구를 여러 번 이어서 부르는 질문도 정상으로 답합니다.
  3. 3.평가로 찾아낸 챗봇 결함 두 가지

    문제
    시험 문제 30개로 처음 채점했을 때 도구 선택 정확도가 0.533이었습니다.
    원인
    문항별로 다시 돌려 보니 두 가지였습니다. AI가 프로젝트 이름을 짐작해 없는 값(localhost-daegu 등)을 넣고 있었고, 도구를 3번 부른 뒤에는 모은 근거가 있어도 답하지 않고 거절했습니다.
    해결
    도구 설명에 실제 프로젝트 이름 목록을 넣어 짐작할 필요가 없게 했습니다. 도구 호출 한도에 닿으면 도구 없이 지금까지 모은 근거로만 답하게 했습니다. 채점 기준도 한 가지 바로잡았습니다. 필요한 도구에 하나를 더 불러 맞게 답한 경우까지 틀렸다고 세고 있었습니다.
    결과
    도구 선택 정확도가 0.867, 답변 근거 적중률이 0.962가 되었습니다. 남은 오답도 문항별로 기록해 두었습니다.
  4. 4.키워드 검색 방식을 측정해서 고르기

    문제
    한국어 키워드 검색에는 전용 방식(PGroonga)이 더 좋다고 알려져 있어, 처음 쓴 방식(pg_trgm)을 바꿔야 할지 정해야 했습니다.
    해결
    두 방식의 차이는 키워드 검색 부분뿐이라, AI 없이 검색만으로 같은 시험 문제 26개를 돌려 비교했습니다. 미리 "0.03 이상 높을 때만 바꾼다"는 기준을 정해 두었습니다.
    결과
    기존 방식이 0.846, 전용 방식이 0.808이라 바꾸지 않았습니다. 이후 프로젝트 소개 페이지를 새로 쓰고 다시 재니 두 방식 모두 0.923으로 같아 그대로 두었습니다. 문항 수가 적어 차이 자체를 확신하기는 어렵다는 점도 함께 기록했습니다.

성과와 회고

0.867

도구 선택 정확도

시험 문제 30개, 소개 페이지 전환 전 측정

0.962

답변 근거 적중률

26개 중, 소개 페이지 전환 전 측정

1.0

거절 정확도

포트폴리오와 무관한 질문 4개

0원

월 운영비

도메인 제외

배운 점

  • 평가 점수가 낮을 때 문항별로 다시 돌려 보면, 모델 탓인지 내 코드 탓인지 채점 기준 탓인지 나눠 볼 수 있었습니다.
  • 무료 한도 같은 운영 조건은 설계 전에 실제 콘솔에서 확인해야 합니다. 문서에 없는 숫자가 설계를 바꿨습니다.
  • 비교는 미리 정한 기준으로 해야 결과를 보고 기준을 바꾸고 싶은 마음을 막을 수 있었습니다.

아쉬운 점과 다음에 할 것

  • 시험 문제를 제가 직접 30개 썼습니다. 실제 방문자 질문을 모아 늘려야 합니다.
  • 평가는 아직 1회 실행 값이고, 프로젝트 소개 페이지를 새로 쓰기 전에 잰 값입니다. 새 페이지 기준으로 다시 재고, 무료 한도 때문에 날짜를 나눠 3회를 채운 뒤 가장 낮은 값을 공개할 계획입니다.
  • 답변 검사는 숫자와 링크만 봅니다. 숫자가 없는 주장이 틀리는 것은 아직 막지 못합니다.